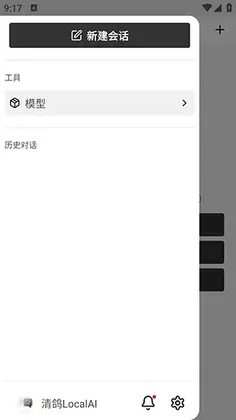

清鸽LocalAI是一款专为大语言模型(LLM)设计的高性能本地客户端,致力于将AI的强大能力直接带到您的设备中。在无需互联网连接的情况下,清鸽LocalAI确保了完整的数据主权和流畅的对话体验。所有的推理和对话均在您的硬件本地完成,任何数据都不会离开您的设备,确保您的交互保持100%私密。它完美支持通过Ollama或LM Studio运行本地离线大模型,隐私安全直接拉满,是注重数据保护与AI体验用户的理想选择。
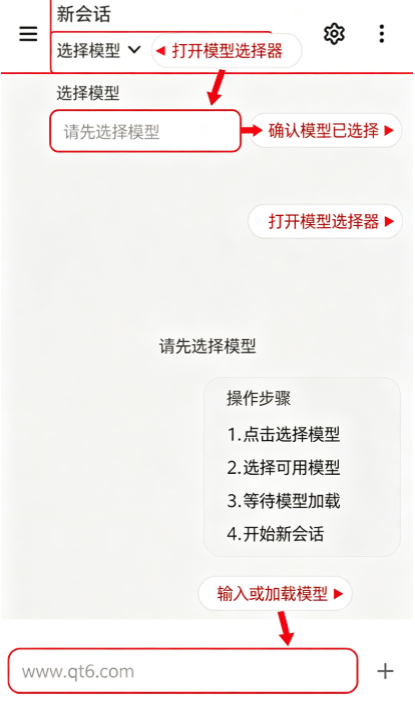
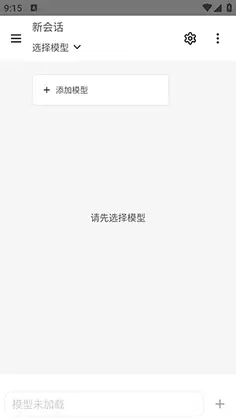
1、打开软件后点击上方的选择模型。
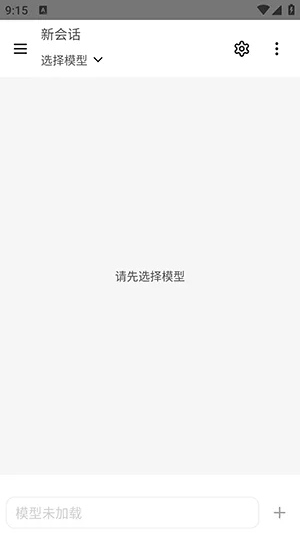
2、点击添加模型。
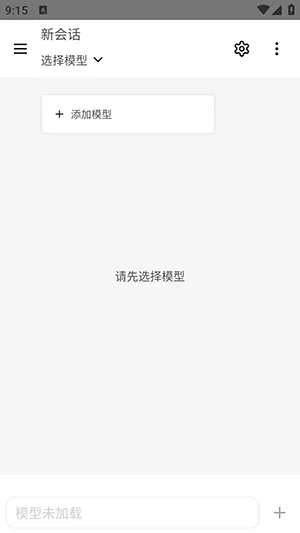
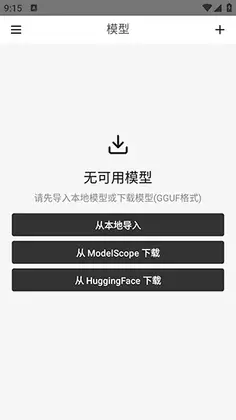
3、可以导入本地模型或直接下载模型。

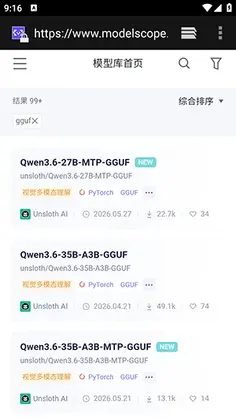
4、点击从 ModelScope 下载,选择需要的模型直接下载即可。
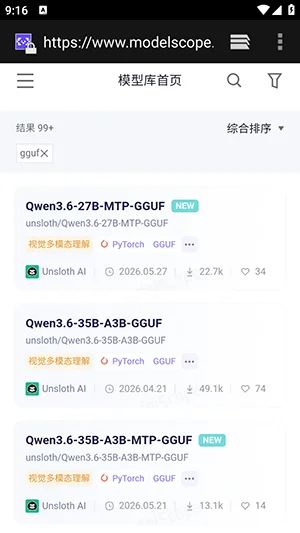
1.首先在本站下载并安装清鸽LocalAI客户端,安装完成后打开软件,进入主界面。
2.在主界面中找到模型管理或模型设置选项,点击进入模型配置页面。
3.根据您的需求选择接入方式,清鸽LocalAI支持Ollama和LM Studio两种本地模型运行方案。
4.若选择Ollama方式,请确保您的设备已安装并运行Ollama服务,然后在清鸽LocalAI中填写对应的本地接口地址。
5.若选择LM Studio方式,请先启动LM Studio并加载所需的大语言模型,再在清鸽LocalAI中配置对应的连接参数。
6.配置完成后返回对话界面,选择您已加载的模型,即可开始与AI进行本地对话。
1.清鸽LocalAI本身不限制具体模型种类,它通过对接Ollama或LM Studio来调用本地模型。
2.通过Ollama,您可以运行Llama系列、Qwen系列、DeepSeek系列、Gemma系列等主流开源大语言模型。
3.通过LM Studio,您可以加载GGUF格式的各类量化模型,兼容性广泛。
4.具体支持哪些模型取决于您在Ollama或LM Studio中下载和加载的模型文件。
5.只要您的硬件性能允许,清鸽LocalAI都能为您提供流畅的本地推理对话体验。
1.清鸽LocalAI的核心设计理念就是完全离线运行,所有推理和对话均在您的硬件本地完成。
2.在首次配置好本地模型连接后,即使断开网络连接,清鸽LocalAI依然可以正常进行AI对话。
3.使用过程中不会向任何远程服务器发送您的对话内容或数据。
4.您的所有交互记录和模型推理结果都保留在本地设备中,确保100%的数据私密性。
5.对于经常处于无网络环境或对数据安全有高要求的用户来说,清鸽LocalAI是非常合适的选择。
1.清鸽LocalAI采用本地推理架构,所有对话数据不会离开您的设备。
2.与云端AI服务不同,清鸽LocalAI不需要将您的提问和回答上传至任何远程服务器。
3.您的对话历史、模型推理过程以及生成内容全部在本地硬件中完成和处理。
4.软件不会收集、存储或传输您的任何交互数据到外部。
5.这种本地化设计从根本上杜绝了数据泄露的风险,让您的AI交互保持完全私密。
1.清鸽LocalAI本身对设备配置要求不高,主要性能压力来自于您选择运行的本地大模型。
2.建议设备至少具备8GB以上内存,若要运行较大的模型则建议16GB或更高内存。
3.处理器方面,较新的多核处理器能提供更好的推理速度。
4.如果设备配有独立显卡或高性能NPU,可以显著提升模型推理效率。
5.存储空间方面,需要预留足够的空间用于存放模型文件,不同模型占用空间从几GB到几十GB不等。
6.总体来说,设备配置越高,能够流畅运行的模型规模就越大,对话体验也越顺畅。
1.清鸽LocalAI是本地运行方案,云端AI需要将数据发送到远程服务器处理。
2.在隐私安全方面,清鸽LocalAI的所有数据都在本地处理,不存在数据外泄风险。
3.在网络依赖方面,清鸽LocalAI配置完成后可完全离线使用,云端AI必须保持网络连接。
4.在使用成本方面,清鸽LocalAI无需支付API调用费用,一次配置即可长期免费使用。
5.在响应速度方面,清鸽LocalAI的推理速度取决于本地硬件性能,云端AI则受网络状况影响。
6.在模型选择方面,清鸽LocalAI支持用户自由选择和切换本地模型,灵活性更高。
1.首先确保您的设备上已正确安装并启动了Ollama服务。
2.在Ollama中通过命令行下载您需要使用的模型,例如执行ollama pull命令获取模型文件。
3.打开清鸽LocalAI,进入设置或模型管理页面。
4.在接入方式中选择Ollama,填写Ollama服务的本地地址,通常为默认的本地端口。
5.保存配置后,清鸽LocalAI会自动检测Ollama中已加载的模型列表。
6.选择您需要的模型即可开始对话,整个过程无需联网。
此内容由AI根据文章内容自动生成,并已由人工审核
Ollama桌面客户端0.33.1 最新版其他软件 · 1.46G · 26-08-29 · 多国语言[中文]Ollama是一款备受推崇的开源大模型本地运行框架,以极简的部署体验,让开发者和AI爱好者能轻松在本地运行Llama 3等主流开源模型,高效又安全。
查看
LM Studio(本地大型语言模型运行平台)0.4.24-1 电脑版行业软件 · 589.0M · 26-09-16 · 多国语言[中文]LM Studio 让你在自己的电脑上轻松运行各种大语言模型,图形界面操作简单,无需命令行基础,是探索本地 AI 的理想选择。
查看
Janitor AI手机版1.0.0安卓版生活服务 · 29.3M · 26-07-08 · 中文家人们,想找个能陪你聊天、陪你演故事的AI吗?Janitor AI手机版来了!全是原创角色,有官方推荐也有玩家自己捏的,每个都有完整人设和性格。对话自然带情绪,聊着聊着还能推动剧情,超有参与感。界面偏英文但指令支持中文,放心用!
查看


百度app手机版 15.77.0.10最新版159.8M / 中文 / 15.77.0.10最新版
下载电子拇指琴 Kalimba 7.3.0 安卓版34.1M / 中文 / 7.3.0 安卓版
下载百度畅听版最新版 7.20.0.90安卓版85.4M / 中文 / 7.20.0.90安卓版
下载掌派云手机最新版本 1.1.95安卓版38.9M / 中文 / 1.1.95安卓版
下载私密相册加密 1.0.1 安卓版34.1M / 中文 / 1.0.1 安卓版
下载岛遇心情 1.0.1 安卓版108.1M / 中文 / 1.0.1 安卓版
下载掌上翻译器 18.0 安卓版91.1M / 中文 / 18.0 安卓版
下载儿童锁家长助手app最新版 1.2.4 安卓版8.4M / 中文 / 1.2.4 安卓版
下载美图设计室免费app 8.22.0安卓版145.7M / 中文 / 8.22.0安卓版
下载多点自动连点器 1.0.0 安卓版95.6M / 中文 / 1.0.0 安卓版
下载雁小侠app官方版 1.6.9.0最新版68.3M / 中文 / 1.6.9.0最新版
下载联想慧眼官方版 5.3.19.01安卓版210.7M / 中文 / 5.3.19.01安卓版
下载172号卡平台app 4.0.7 最新版75.0M / 中文 / 4.0.7 最新版
下载百灵钥匙 1.0.3 安卓版66.9M / 中文 / 1.0.3 安卓版
下载弦趣二胡音准练习app 14.5安卓版87.7M / 中文 / 14.5安卓版
下载时间不说谎 1.1.2 安卓版30.4M / 中文 / 1.1.2 安卓版
下载来音节拍器官方版 2.12.8安卓版156.8M / 中文 / 2.12.8安卓版
下载秘塔AI搜索app最新版本 2.8.1安卓版52.3M / 中文 / 2.8.1安卓版
下载奥维互动地图手机版官方版卫星地图 10.7.3.36288安卓版90.8M / 中文 / 10.7.3.36288安卓版
下载欢太工具箱官方版 16.12安卓版10.7M / 中文 / 16.12安卓版
下载装哔截图模拟生成神器 8.1 安卓版59.7M / 中文 / 8.1 安卓版
下载梵想云 2.2.0 最新版57.1M / 中文 / 2.2.0 最新版
下载YeeMall官方版 2.8.4 最新版121.0M / 中文 / 2.8.4 最新版
下载互传换机助手app 1.4.8最新版28.1M / 中文 / 1.4.8最新版
下载社区管理系统 1.8.1 最新版32.3M / 中文 / 1.8.1 最新版
下载投智圈官方版 3.4.8安卓版79.4M / 中文 / 3.4.8安卓版
下载元道经纬相机官方版 7.0.4升级版149.2M / 中文 / 7.0.4升级版
下载桌面宠物3d 1.0.15安卓版71.3M / 中文 / 1.0.15安卓版
下载柠檬云进销存 4.2.13 最新版87.7M / 中文 / 4.2.13 最新版
下载MFAAvalonia软件 1.0 安卓版113.1M / 中文 / 1.0 安卓版
下载我嘞个拼豆 1.0.1 安卓版187.9M / 中文 / 1.0.1 安卓版
下载微聊天记录误删备份 1.0.3 安卓版29.7M / 中文 / 1.0.3 安卓版
下载手机数据管家app 1.3.136 安卓版100.1M / 中文 / 1.3.136 安卓版
下载信用查询中心app最新版 1.8.7 安卓版37.7M / 中文 / 1.8.7 安卓版
下载手机全能空调遥控器精灵app 1.0.0 安卓版38.5M / 中文 / 1.0.0 安卓版
下载qq浏览器官方免费 20.6.2.2048安卓版145.4M / 中文 / 20.6.2.2048安卓版
下载搜狗浏览器极速版最新版 20.1.5.1055 安卓版148.0M / 中文 / 20.1.5.1055 安卓版
下载百度网盘最新版本 13.33.7安卓版331.7M / 中文 / 13.33.7安卓版
下载QQ同步助手 8.0.2381.8M / 中文 / 8.0.23
下载快牙软件 6.7.4 CN CN CN安卓版24.3M / 中文 / 6.7.4 CN CN CN安卓版
下载讯飞输入法app官方版 15.0.26安卓版68.2M / 中文 / 15.0.26安卓版
下载qq输入法官方版 8.7.14安卓版33.4M / 中文 / 8.7.14安卓版
下载搜狗输入法官方正版 10.7安卓版49.5M / 中文 / 10.7安卓版
下载uc浏览器app 12.7.6.1056安卓版54.8M / 中文 / 12.7.6.1056安卓版
下载安兔兔评测 8608c5b14安卓版15.8M / 中文 / 8608c5b14安卓版
下载安卓壁纸app 5.15.33官方版42.7M / 中文 / 5.15.33官方版
下载qq安全中心app最新版 7.3.7安卓版12.7M / 中文 / 7.3.7安卓版
下载猎豹清理大师2025年最新版 6.23.5安卓版46.1M / 中文 / 6.23.5安卓版
下载安卓动态壁纸 4.3.125.6M / 中文 / 4.3.1
下载re管理器最新版(Root Explorer) 4.12.2安卓版4.1M / 中文 / 4.12.2安卓版
下载猎豹安全大师手机版 5.2.7.1058最新版22.8M / 中文 / 5.2.7.1058最新版
下载微盘 3.6.115.3M / 中文 / 3.6.1
下载双开助手微信分身多开版免费 7.8.4安卓版11.1M / 中文 / 7.8.4安卓版
下载微信清理Cleaner for Wechat 1.3.174.5M / 中文 / 1.3.17
下载谷歌play商店官方正版(Google Play 商店) 53.0.27-34 [0] [PR] 973951861最新版本72.9M / 中文 / 53.0.27-34 [0] [PR] 973951861最新版本
下载谷歌商店最新版2026(Google Play商店) 53.0.27-34 [0] [PR] 973951861手机安卓版72.9M / 中文 / 53.0.27-34 [0] [PR] 973951861手机安卓版
下载shizuku官方版安卓最新版 13.7.0手机版31.5M / 中文 / 13.7.0手机版
下载google play商店最新版本 53.0.27-34 [0] [PR] 973951861安卓官方版72.9M / 中文 / 53.0.27-34 [0] [PR] 973951861安卓官方版
下载火狐浏览器安卓版(Firefox) 156.0最新版595.6M / 中文 / 156.0最新版
下载小虎软件库官方版 3.4安卓版6.3M / 中文 / 3.4安卓版
下载谷歌服务框架最新版2026(google play 服务) 26.33.30 (260400-965716001)手机版301.8M / 中文 / 26.33.30 (260400-965716001)手机版
下载fake location官方版 1.3.5 BETA安卓版22.7M / 中文 / 1.3.5 BETA安卓版
下载np管理器官方正版 3.1.43安卓版45.6M / 中文 / 3.1.43安卓版
下载qq同步助手app 8.0.23最新安卓版81.8M / 中文 / 8.0.23最新安卓版
下载pikpak最新版 2.2.0安卓版80.4M / 中文 / 2.2.0安卓版
下载app分享2026(appshare) 5.1.5安卓版36.3M / 中文 / 5.1.5安卓版
下载Pi Browser最新版 1.6.1官方安卓版37.0M / 中文 / 1.6.1官方安卓版
下载谷歌搜索引擎手机版(Google) 17.59.18.ve.arm64最新版224.9M / 中文 / 17.59.18.ve.arm64最新版
下载谷歌输入法安卓版官方版(Gboard) 18.3.1.977415014-release-arm64-v8a手机版75.9M / 中文 / 18.3.1.977415014-release-arm64-v8a手机版
下载奇妙应用2026 1.3.9安卓版15.7M / 中文 / 1.3.9安卓版
下载sam helper软件 v2.8.0安卓版37.8M / 中文 / v2.8.0安卓版
下载太极app安卓版 14.0.7.05010904手机版9.6M / 中文 / 14.0.7.05010904手机版
下载小米浏览器官方最新版本 20.25.1020805安卓版244.7M / 中文 / 20.25.1020805安卓版
下载小草助手手机版app 1.10安卓版29.9M / 中文 / 1.10安卓版
下载APKPure官方正版 3.20.7803最新版22.8M / 中文 / 3.20.7803最新版
下载卓聚社区最新版 1.7.1.0223安卓版18.2M / 中文 / 1.7.1.0223安卓版
下载vivo应用商店官方正版 10.4.2.0安卓版50.8M / 中文 / 10.4.2.0安卓版
下载Gmail最新版本(谷歌邮箱) 2026.08.31.977101690.Release手机版193.1M / 中文 / 2026.08.31.977101690.Release手机版
下载光速虚拟机官方版最新版本 11.0安卓版1.24G / 中文 / 11.0安卓版
下载我在ai app官方版 3.1.9最新版69.4M / 中文 / 3.1.9最新版
下载孤煞软件库最新版本 4.4.0安卓版9.3M / 中文 / 4.4.0安卓版
下载极客软件库官方版 3.7.0安卓版12.8M / 中文 / 3.7.0安卓版
下载edge浏览器官方安卓版 153.0.4234.32最新版252.5M / 中文 / 153.0.4234.32最新版
下载IQQI 快注音键盘输入法 2.3.0028.0安卓版17.7M / 中文 / 2.3.0028.0安卓版
下载手机性能排行app最新版2026 v5.1.7安卓版8.9M / 中文 / v5.1.7安卓版
下载StandBy官方版 2.0.40.538安卓版24.7M / 中文 / 2.0.40.538安卓版
下载挖软app2026最新版 8.2安卓版9.8M / 中文 / 8.2安卓版
下载花瓣测速最新版 4.8.0.307安卓版43.4M / 中文 / 4.8.0.307安卓版
下载KernelSU面具最新版 v3.3.0安卓版10.3M / 中文 / v3.3.0安卓版
下载