
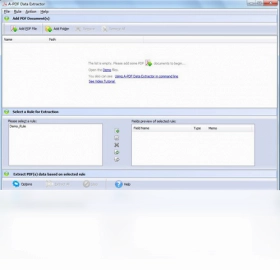
A-PDF Data Extractor是一款高效实用的PDF数据提取工具,专为需要从大量PDF文档中批量采集文字信息的用户设计。它支持将PDF中的文本内容快速导出为XLS、CSV或XML格式,方便后续的数据分析与归档。软件内置可视化的PDF数据提取规则编辑器,让用户能够直观地验证并确定所需的数据字段,从而实现精准的自动化提取。无论是处理财务报表、发票清单还是调查报告,A-PDF Data Extractor都能显著提升工作效率,减少手动录入的错误与繁琐。
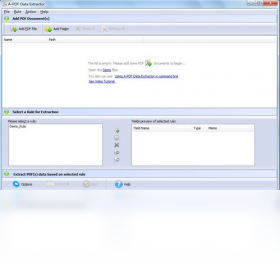
1.启动A-PDF Data Extractor,在主界面点击“新建任务”按钮,导入需要处理的PDF文件。
2.进入规则编辑器界面,使用鼠标框选PDF页面中需要提取的数据区域,软件会自动识别文本块。
3.在右侧属性面板中,为选中的区域指定字段名称,例如“日期”、“金额”或“客户名称”。
4.针对不同页面结构,可以添加多个规则条件,确保跨页数据也能准确匹配。
5.点击“预览”按钮,查看提取结果是否符合预期,如有偏差可微调选区范围。
6.确认无误后保存规则模板,方便后续处理同类PDF文件时直接调用。
1.软件原生支持将提取的数据导出为Microsoft Excel(XLS)工作簿,便于进行表格计算与图表制作。
2.支持CSV逗号分隔值文件,兼容绝大多数数据库和数据分析软件。
3.可输出为XML结构化文档,适合需要与Web服务或应用程序进行数据交换的场景。
4.在导出设置中,用户还可以自定义字段分隔符、编码格式以及是否包含表头。
5.对于批量任务,软件允许将多个PDF的提取结果合并输出到同一个文件中。
| 功能 | 快捷键 |
|---|---|
| 打开PDF文件 | Ctrl + O |
| 保存当前任务 | Ctrl + S |
| 开始提取 | F5 |
| 放大页面 | Ctrl + + |
| 缩小页面 | Ctrl + - |
1.检查PDF文件是否被加密或设置了权限限制,如有则需先解除保护。
2.确认提取规则是否适用于所有待处理文件,不同版式的PDF可能需要单独调整规则。
3.查看软件日志或错误提示,定位具体是哪个文件或哪个字段导致了失败。
4.尝试降低提取精度要求,或勾选“忽略无法识别的页面”选项继续执行。
5.若问题依旧,可尝试将PDF拆分为单页文件后重新批量导入。
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7 | Windows 10/11 |
| 处理器 | 1 GHz | 2 GHz 及以上 |
| 内存 | 1 GB | 4 GB 及以上 |
| 硬盘空间 | 100 MB | 500 MB 以上 |
1.软件采用先进的文本识别算法,对于标准PDF文档的提取准确率较高。
2.通过可视化规则编辑器,用户可以精确框选数据区域,避免无关内容的干扰。
3.支持对提取结果进行二次校验,可手动修正个别识别错误的字段。
4.对于扫描件或图片型PDF,建议先使用OCR工具转换为可搜索文本再提取。
5.定期更新软件版本有助于获得更优的识别引擎和错误修复。
1.A-PDF Data Extractor主要针对PDF内嵌的文本层进行提取,纯图片PDF需借助OCR功能。
2.如果PDF由扫描生成,建议先用Adobe Acrobat等工具执行“识别文本”操作。
3.部分版本支持调用外部OCR引擎,可在设置中配置Tesseract等开源工具路径。
4.对于少量图片文字,也可以使用截图工具配合其他OCR软件手动处理。
5.提取后的文本仍可导出为XLS、CSV或XML格式,保持工作流一致。
此内容由AI根据文章内容自动生成,并已由人工审核


 Windows 11

novelWriter官方版(文本编辑器) 26.2.1 电脑版97.5M / 多国语言[中文] / 26.2.1 电脑版
下载思源笔记绿色版 3.8.6 最新版278.5M / 中文 / 3.8.6 最新版
下载QOwnNotes电脑版(开源Markdown笔记本) 26.9.14免费版51.3M / 多国语言[中文] / 26.9.14免费版
下载职称计算机直考通之wpsoffice软件 3.2 电脑版41.2M / 中文 / 3.2 电脑版
下载豆豆小学生口算练习系统最新版 3.0 电脑版2.1M / 中文 / 3.0 电脑版
下载记账小管家最新版 1.0.1.0 电脑版769KB / 中文 / 1.0.1.0 电脑版
下载超级记忆馆记忆力训练软件 2.0.0.0 电脑版37.6M / 中文 / 2.0.0.0 电脑版
下载语言岛智能记单词软件 0.3.4.554 电脑版14.2M / 中文 / 0.3.4.554 电脑版
下载飚风信封快递单打印软件最新版 3.51 电脑版25.0M / 中文 / 3.51 电脑版
下载TeamDoc文档管理软件最新版 2.0.0.2 电脑版6.8M / 中文 / 2.0.0.2 电脑版
下载Nuance PDF Reader最新版 1.3.1.1 电脑版18.1M / 英文 / 1.3.1.1 电脑版
下载视听英语学习王 4.8 电脑版67.1M / 中文 / 4.8 电脑版
下载通用材料出库单打印系统 1.0 电脑版332KB / 中文 / 1.0 电脑版
下载Demo Builder (演示制作工具) 8.2.2.0 电脑版23.5M / 英文 / 8.2.2.0 电脑版
下载快乐排课系统 5.7.0.0 电脑版3.7M / 中文 / 5.7.0.0 电脑版
下载西语助手汉西西汉词典 2.01 电脑版18.3M / 中文 / 2.01 电脑版
下载WPS Office教育版 12.1.0.25225 电脑版333.9M / 中文 / 12.1.0.25225 电脑版
下载追光PDF 3.0.0.1 电脑版14.3M / 中文 / 3.0.0.1 电脑版
下载九雷Word加密解密器 1.0.3.0 电脑版74.0M / 中文 / 1.0.3.0 电脑版
下载福昕翻译大师软件 1.6.1209.735 电脑版14.2M / 中文 / 1.6.1209.735 电脑版
下载pdfFactory软件 8.1.0.0 电脑版14.5M / 英文 / 8.1.0.0 电脑版
下载惠新PDF合并分割器 2.0.0.10 电脑版8.3M / 中文 / 2.0.0.10 电脑版
下载极速PDF编辑器 3.0.8.0 电脑版73.2M / 中文 / 3.0.8.0 电脑版
下载WordWeb最新版 6.0.2.0 电脑版18.4M / 英文 / 6.0.2.0 电脑版
下载WinEdt软件 10.3.2018.507 电脑版9.1M / 英文 / 10.3.2018.507 电脑版
下载有道云笔记pc版 5.8.0.1 电脑版60.1M / 中文 / 5.8.0.1 电脑版
下载万兴PDF专家软件 12.0.5 电脑版2.3M / 多国语言[中文] / 12.0.5 电脑版
下载慧影个人智能信息系统最新版 3.1.8 电脑版226.1M / 中文 / 3.1.8 电脑版
下载STDU Viewer 1.6.375.0 电脑版2.5M / 多国语言[中文] / 1.6.375.0 电脑版
下载Zava (Java智能问答助手) 1.0.0.0 电脑版3.4M / 多国语言[中文] / 1.0.0.0 电脑版
下载ET-PDF转换器 2.2.0.0 官方正式版42.2M / 中文 / 2.2.0.0 官方正式版
下载北斗PDF转换器 6.2.0.0 电脑版43.7M / 中文 / 6.2.0.0 电脑版
下载闪电PDF编辑器 3.2.7.0 电脑版41.3M / 中文 / 3.2.7.0 电脑版
下载云客送货单管理软件 3.13.0.0 电脑版26.4M / 中文 / 3.13.0.0 电脑版
下载捷龙PDF转换器 3.0.6.16 电脑版42.1M / 中文 / 3.0.6.16 电脑版
下载Xmind 2026解锁高级版 26.05.01107最新版本157.3M / 中文 / 26.05.01107最新版本
下载WPS Office 2023专业版免会员 12.1.0.26899免费版437.8M / 中文 / 12.1.0.26899免费版
下载WPS2019博湖县政府版 11.8.2.10229政府定制版279.1M / 中文 / 11.8.2.10229政府定制版
下载WPS Office 2016极限精简版 2020年12月版31.3M / 中文 / 2020年12月版
下载Xmind 2025永久激活版 163.3M / 中文 /
下载福昕PDF阅读器官方正版(Foxit Reader) 2026.2.0.39747 最新版350.9M / 多国语言[中文] / 2026.2.0.39747 最新版
下载InDesign 2024软件 v19.5.0.84直装版1.42G / 中文 / v19.5.0.84直装版
下载LibreOffice最新版本(Office 办公套件) 26.8.0 中文版342.9M / 多国语言[中文] / 26.8.0 中文版
下载PDFgear(PDF工具) 2.1.20 最新版133.8M / 多国语言[中文] / 2.1.20 最新版
下载InDesign 2022破解版 v17.4.0.51中文版958.3M / 中文 / v17.4.0.51中文版
下载veyon(电子教室管理)官方版 4.11.3.0电脑版16.0M / 中文 / 4.11.3.0电脑版
下载SketchUp版本转换器最新版 1.0.0官方版5.6M / 中文 / 1.0.0官方版
下载Xournal++(手写笔记工具) 1.3.7便携版93.7M / 多国语言[中文] / 1.3.7便携版
下载给力大辞典绿色便携版 2.20离线版199.6M / 中文 / 2.20离线版
下载搜狗输入法电脑版最新版本 16.8.0.4914 pc版74.5M / 中文 / 16.8.0.4914 pc版
下载亿图图示绿色版(EdrawMax) 15.2.9.1577 特别版193.1M / 中文 / 15.2.9.1577 特别版
下载Microsoft Office专业增强版2021 RTM 官方正式版4.19G / 英文 / RTM 官方正式版
下载Recoll(文件内容搜索器)绿色中文版 1.28.6单文件版103.8M / 中文 / 1.28.6单文件版
下载给力牛津词典官方PC版 2.0电脑版92.7M / 中文 / 2.0电脑版
下载wps桌面版 12.1,0.26895最新版285.7M / 中文 / 12.1,0.26895最新版
下载AI语音合成官方版 0.70电脑版553KB / 中文 / 0.70电脑版
下载Xmind 2021简体中文永久安装版 193M / 中文 /
下载LTspice(电路仿真工具) 26.2 汉化便携版95.0M / 中文 / 26.2 汉化便携版
下载XMind 2023激活版免费版 136.5M / 中文 /
下载Obsidian(黑曜石Markdown笔记) 1.13.7 电脑版315.7M / 多国语言[中文] / 1.13.7 电脑版
下载Cherry Studio智能体(模型服务聚合) 2.0.12 PC版283.9M / 中文 / 2.0.12 PC版
下载OfficeMind官方版 1.1.14 最新版27.8M / 中文 / 1.1.14 最新版
下载我的ABC软件工具箱软件 6.6.1 最新版150.5M / 中文 / 6.6.1 最新版
下载微软office2024镜像激活版 长期支持版26年07月更新版3.02G / 中文 / 长期支持版26年07月更新版
下载Adobe InDesign 2026中文激活版 21.6.0.57电脑版1.50G / 中文 / 21.6.0.57电脑版
下载万彩办公大师(OfficeBox)绿色便携版 3.0.7绿色免费版16.9M / 中文 / 3.0.7绿色免费版
下载universal extractor(万能解包提取工具) 2022-01-06 中文增强版45.1M / 中文 / 2022-01-06 中文增强版
下载InDesign 2025免费版本 v20.5.0.48中文版1.48G / 中文 / v20.5.0.48中文版
下载谷歌日语输入法 1.3.21.111最新版723KB / 中文 / 1.3.21.111最新版
下载WorkBuddy AI办公助手 5.3.8 最新版388.4M / 中文 / 5.3.8 最新版
下载