


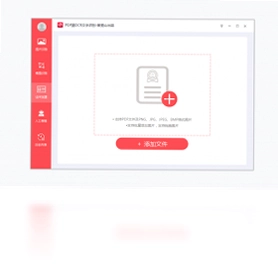
PDF猫OCR文字识别电脑版是一款专注于图片与PDF文档内容提取的高效办公工具,能够帮助用户快速将图片、扫描件以及PDF文件中的文字转换为可编辑文本。该软件支持jpg、jpeg、png和bmp等多种图片格式识别,同时提供直接截图识别功能,无需保存图片即可完成文字提取。针对办公场景,PDF猫OCR文字识别还内置了身份证、银行卡、驾驶证、行驶证、发票、营业执照等证件发票识别模板,并支持批量识别与对比识别,满足财务、行政、法务等不同岗位的多样化需求,显著提升文字录入效率。
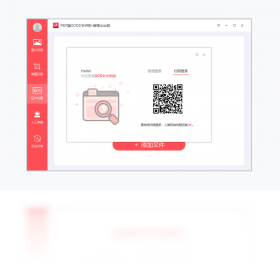
1.打开PDF猫OCR文字识别电脑版,在主界面左侧选择对应的识别功能模块,如“图片识别”或“PDF识别”。
2.点击“添加文件”按钮,将需要识别的图片或PDF文件导入到软件列表中,支持一次性添加多张图片。
3.在右侧参数设置区域选择识别语言和输出格式,通常默认设置为“中文+英文”混合识别模式。
4.点击“开始识别”按钮,软件会自动对文件进行预处理、版面分析和文字提取,识别速度与文件大小及数量有关。
5.识别完成后,右侧预览区会显示识别结果,用户可对照原图检查文字是否有误,支持手动修改个别错别字。
6.确认无误后点击“导出”按钮,可将识别结果保存为TXT、Word或Excel等格式,方便后续编辑使用。

1.启动PDF猫OCR文字识别电脑版,在功能导航栏中找到“证件识别”或“发票识别”专用入口。
2.根据实际需求选择对应的证件类型,软件目前支持身份证、银行卡、驾驶证、行驶证、发票和营业执照等常见证件。
3.将证件图片拖拽到识别区域,或者点击“上传图片”按钮从本地文件夹中选取证件照片。
4.软件会自动定位证件边缘并校正倾斜角度,对于拍摄角度不佳的图片也能进行智能矫正。
5.点击“识别”后,软件会提取证件上的关键字段信息,如姓名、证件号码、有效期等,并以结构化形式展示。
6.用户可核对识别出的字段内容,确认后导出为Excel表格,便于批量录入和存档管理。
1.打开PDF猫OCR文字识别电脑版,点击顶部菜单栏的“批量识别”选项,进入批量处理模式。
2.点击“添加文件夹”或“添加文件”按钮,将多张图片或多个PDF文件一次性导入到待识别列表中。
3.在列表下方设置统一的识别参数,包括识别语言、输出格式和保存路径,确保所有文件按相同规则处理。
4.点击“批量识别”按钮,软件会按照队列顺序依次处理每个文件,并在界面中显示整体进度和当前处理状态。
5.识别过程中可随时暂停或取消任务,已完成的部分会自动保存,避免重复劳动。
6.全部识别结束后,点击“导出全部”按钮,软件会将所有识别结果合并或分别保存到指定文件夹中。

| 功能 | 快捷键 |
|---|---|
| 截图识别 | Ctrl+Alt+Q |
| 打开图片 | Ctrl+O |
| 开始识别 | F5 |
| 导出结果 | Ctrl+S |
| 放大预览 | Ctrl+加号 |
| 缩小预览 | Ctrl+减号 |
1.在PDF猫OCR文字识别电脑版主界面选择“对比识别”模式,该功能适用于合同、标书等需要核对两版文字差异的场景。
2.分别导入原始文件和修改后的文件,支持图片或PDF格式,软件会自动进行版面分析和文字对齐。
3.点击“开始对比”按钮,软件会逐行比对两份文件的文字内容,并高亮显示新增、删除和修改的部分。
4.对比结果以左右分栏形式展示,左侧为原始内容,右侧为修改后内容,差异处用不同颜色标注。
5.用户可逐条查看差异项,确认是否为需要保留的修改,避免人工核对遗漏关键改动。
6.确认完毕后可将对比报告导出为Word或PDF文件,作为修改记录存档备查。

| 项目 | 最低配置 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7 | Windows 10/11 |
| 处理器 | 1.5GHz 双核 | 2.0GHz 四核及以上 |
| 内存 | 2GB | 4GB及以上 |
| 硬盘空间 | 200MB可用空间 | 500MB以上可用空间 |
| 显示分辨率 | 1024×768 | 1920×1080及以上 |
1.运行PDF猫OCR文字识别电脑版,确保软件处于后台运行状态,以便随时调用截图识别功能。
2.按下截图识别快捷键Ctrl+Alt+Q,屏幕会进入截图模式,鼠标指针变为十字光标。
3.按住鼠标左键拖动框选需要识别的屏幕区域,松开鼠标后软件会自动截取该区域图像。
4.截图完成后软件主界面会自动弹出并将截图显示在预览区,无需手动保存图片文件。
5.点击“开始识别”按钮,软件会立即对截图内容进行文字提取,几秒内即可显示识别结果。
6.识别完成后可直接复制文字到剪贴板,或导出为TXT文件保存到本地。
此内容由AI根据文章内容自动生成,并已由人工审核



云橙PDF编辑器 7.4.4 电脑版31.2M / 中文 / 7.4.4 电脑版
下载速易签软件 1.0.0.0 电脑版5.2M / 中文 / 1.0.0.0 电脑版
下载小鹿拓创意 1.0.612.8356 电脑版3.1M / 中文 / 1.0.612.8356 电脑版
下载旋风PDF阅读器 1.0.0.3 电脑版10.5M / 中文 / 1.0.0.3 电脑版
下载自助听写 1.0 电脑版2.0M / 中文 / 1.0 电脑版
下载搜狗输入法企业版最新版 1.0.0.1191 电脑版163.4M / 中文 / 1.0.0.1191 电脑版
下载悦书PDF转换器 1.0.0.0 电脑版123.0M / 中文 / 1.0.0.0 电脑版
下载OfficeFIX 6.66 电脑版15.4M / 英文 / 6.66 电脑版
下载全能王PDF编辑器 2.0.0.4 电脑版3.1M / 中文 / 2.0.0.4 电脑版
下载QOwnNotes电脑版(开源Markdown笔记本) 26.9.9免费版51.2M / 多国语言[中文] / 26.9.9免费版
下载Verse软件 1.0.10 pc版101.0M / 中文 / 1.0.10 pc版
下载JP-Word简谱编辑软件最新版 4.95.0.0 电脑版12.8M / 中文 / 4.95.0.0 电脑版
下载扫票宝 1.0.0.28 电脑版72.7M / 中文 / 1.0.0.28 电脑版
下载旋风转换器 8.6.0.0 电脑版21.4M / 中文 / 8.6.0.0 电脑版
下载时代契约 1.0.0.0 电脑版90.8M / 中文 / 1.0.0.0 电脑版
下载Print Conductor软件 7.0.0.0 电脑版96.8M / 英文 / 7.0.0.0 电脑版
下载习讲PPT 4.0 电脑版51.6M / 中文 / 4.0 电脑版
下载紫辰记账本 5.9.0.0 电脑版1.3M / 中文 / 5.9.0.0 电脑版
下载Blumind软件 1.3.1.0 电脑版540KB / 多国语言[中文] / 1.3.1.0 电脑版
下载敬业签 3.4.2.0 电脑版94.9M / 中文 / 3.4.2.0 电脑版
下载极速玩转最新版 3.0.1.5 电脑版35.3M / 中文 / 3.0.1.5 电脑版
下载优思授课系统 2.0.1.1803 电脑版63.0M / 中文 / 2.0.1.1803 电脑版
下载Icecream Ebook Reader 5.24 电脑版28.2M / 英文 / 5.24 电脑版
下载百度文库 3.4.0.0 电脑版77.5M / 中文 / 3.4.0.0 电脑版
下载思想快车(ThinkingExpress ) 2.0.0.1 电脑版934KB / 中文 / 2.0.0.1 电脑版
下载极强PDF转换成WORD转换器 5.2.3.0 电脑版40.2M / 中文 / 5.2.3.0 电脑版
下载GitMind 1.0.8.0 电脑版1.8M / 中文 / 1.0.8.0 电脑版
下载W大师PDF转换器 1.3.1.0 电脑版13.7M / 中文 / 1.3.1.0 电脑版
下载myPlan(桌面事务管理) 1.0.0.0 电脑版842KB / 中文 / 1.0.0.0 电脑版
下载华强CRM客户管理软件最新版 7.7 电脑版12.3M / 中文 / 7.7 电脑版
下载链签-区块链智能合同管理软件最新版 1.0.0.0 电脑版96.7M / 中文 / 1.0.0.0 电脑版
下载石墨文档 3.5.0.0 最新版326.4M / 中文 / 3.5.0.0 最新版
下载CintaNotes 3.0.2.2 电脑版7.7M / 英文 / 3.0.2.2 电脑版
下载易特商店宝 1.0.0.1 电脑版31.1M / 中文 / 1.0.0.1 电脑版
下载闪电PDF阅读器 2.1.5.0 最新版75.1M / 中文 / 2.1.5.0 最新版
下载Xmind 2026解锁高级版 26.05.01107最新版本157.3M / 中文 / 26.05.01107最新版本
下载WPS2019博湖县政府版 11.8.2.10229政府定制版279.1M / 中文 / 11.8.2.10229政府定制版
下载WPS Office 2023专业版免会员 12.1.0.26899免费版437.8M / 中文 / 12.1.0.26899免费版
下载WPS Office 2016极限精简版 2020年12月版31.3M / 中文 / 2020年12月版
下载福昕PDF阅读器官方正版(Foxit Reader) 2026.2.0.39747 最新版350.9M / 多国语言[中文] / 2026.2.0.39747 最新版
下载Xmind 2025永久激活版 163.3M / 中文 /
下载LibreOffice最新版本(Office 办公套件) 26.8.0 中文版342.9M / 多国语言[中文] / 26.8.0 中文版
下载InDesign 2024软件 v19.5.0.84直装版1.42G / 中文 / v19.5.0.84直装版
下载InDesign 2022破解版 v17.4.0.51中文版958.3M / 中文 / v17.4.0.51中文版
下载SketchUp版本转换器最新版 1.0.0官方版5.6M / 中文 / 1.0.0官方版
下载给力大辞典绿色便携版 2.20离线版199.6M / 中文 / 2.20离线版
下载veyon(电子教室管理)官方版 4.11.3.0电脑版16.0M / 中文 / 4.11.3.0电脑版
下载搜狗输入法电脑版最新版本 16.8.0.4914 pc版74.5M / 中文 / 16.8.0.4914 pc版
下载PDFgear(PDF工具) 2.1.20 最新版133.8M / 多国语言[中文] / 2.1.20 最新版
下载Xournal++(手写笔记工具) 1.3.7便携版93.7M / 多国语言[中文] / 1.3.7便携版
下载Microsoft Office专业增强版2021 RTM 官方正式版4.19G / 英文 / RTM 官方正式版
下载亿图图示绿色版(EdrawMax) 15.2.9.1577 特别版193.1M / 中文 / 15.2.9.1577 特别版
下载Recoll(文件内容搜索器)绿色中文版 1.28.6单文件版103.8M / 中文 / 1.28.6单文件版
下载给力牛津词典官方PC版 2.0电脑版92.7M / 中文 / 2.0电脑版
下载AI语音合成官方版 0.70电脑版553KB / 中文 / 0.70电脑版
下载wps桌面版 12.1,0.26895最新版285.7M / 中文 / 12.1,0.26895最新版
下载Xmind 2021简体中文永久安装版 193M / 中文 /
下载XMind 2023激活版免费版 136.5M / 中文 /
下载Cherry Studio智能体(模型服务聚合) 2.0.12 PC版283.9M / 中文 / 2.0.12 PC版
下载OfficeMind官方版 1.1.14 最新版27.8M / 中文 / 1.1.14 最新版
下载Obsidian(黑曜石Markdown笔记) 1.13.7 电脑版315.7M / 多国语言[中文] / 1.13.7 电脑版
下载Adobe InDesign 2026中文激活版 21.6.0.57电脑版1.50G / 中文 / 21.6.0.57电脑版
下载微软office2024镜像激活版 长期支持版26年07月更新版3.02G / 中文 / 长期支持版26年07月更新版
下载万彩办公大师(OfficeBox)绿色便携版 3.0.7绿色免费版16.9M / 中文 / 3.0.7绿色免费版
下载universal extractor(万能解包提取工具) 2022-01-06 中文增强版45.1M / 中文 / 2022-01-06 中文增强版
下载InDesign 2025免费版本 v20.5.0.48中文版1.48G / 中文 / v20.5.0.48中文版
下载谷歌日语输入法 1.3.21.111最新版723KB / 中文 / 1.3.21.111最新版
下载我的ABC软件工具箱软件 6.6.1 最新版150.5M / 中文 / 6.6.1 最新版
下载Koodo Reader(跨平台电子书阅读器) 2.4.4 电脑版101.9M / 多国语言[中文] / 2.4.4 电脑版
下载LTspice(电路仿真工具) 26.2 汉化便携版95.0M / 中文 / 26.2 汉化便携版
下载