
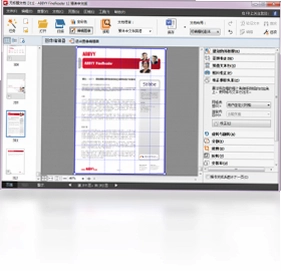
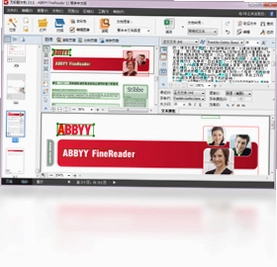
ABBYY FineReader是一款专业的OCR图片文字识别软件,能够快速、准确地将扫描文件、PDF文档、数字照片以及手机拍摄的图像转换成可编辑的文本格式。它采用先进的OCR技术,识别准确率高达99.8%,支持识别几乎所有打印文档类型,甚至传真文件也能精准转换。无论是办公文档数字化、图书资料整理还是票据信息提取,ABBYY FineReader都能大幅提升工作效率,是文字识别领域的标杆级工具。
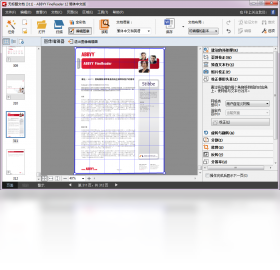
1.ABBYY FineReader采用自适应OCR引擎,能够智能分析文档的字体、排版和图像质量,自动优化识别参数。
2.对于印刷体文档,其识别准确率可达99.8%以上,即便是低分辨率扫描件也能保持较高精度。
3.软件内置多国语言识别模型,中英文混排文档也能准确区分并识别。
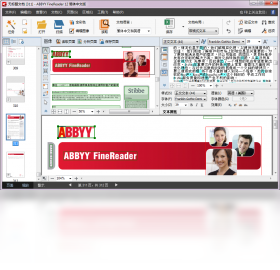
4.对于表格、多栏排版等复杂版式,ABBYY FineReader能自动保留原始布局结构。
5.识别完成后可一键导出为Word、Excel、PDF等可编辑格式,方便后续处理。
6.用户还可手动校对识别结果,软件会高亮显示低置信度字符,便于快速修正。
1.支持批量处理多个文件,可一次性导入大量扫描件或PDF进行批量识别转换。
2.内置PDF编辑功能,可直接对PDF文档进行文字修改、注释添加和页面管理。
3.提供文档对比功能,能快速找出两个版本文档之间的差异内容。
4.支持从数码相机和手机拍摄的图像中提取文字,自动校正倾斜和透视变形。
5.具备强大的表格识别能力,可将图片中的表格精准还原为Excel可编辑格式。
6.支持保存为可搜索PDF,方便日后通过关键词快速定位文档内容。
7.提供多语言界面和识别语言切换,满足不同用户的使用需求。
| 操作功能 | 快捷键 |
|---|---|
| 打开文件 | Ctrl+O |
| 保存文件 | Ctrl+S |
| 开始识别 | Ctrl+R |
| 导出文档 | Ctrl+E |
| 打印 | Ctrl+P |
| 撤销操作 | Ctrl+Z |
| 重做操作 | Ctrl+Y |
| 全选 | Ctrl+A |
| 查找 | Ctrl+F |
| 缩放页面 | Ctrl+滚轮 |
1.扫描或拍摄时尽量保证图像清晰、光照均匀,避免出现阴影和反光。
2.将文档摆放端正,减少倾斜角度,有助于OCR引擎更准确地分析版面。
3.在识别前手动选择正确的文档语言,避免因语言设置错误导致识别率下降。
4.对于低质量图像,可先使用软件自带的图像预处理功能进行去噪和增强。
5.合理设置识别区域,排除页眉页脚、页码等不需要识别的内容。
6.识别完成后利用校对工具逐字检查,重点关注软件标记的低置信度区域。
| 配置项 | 最低要求 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7 | Windows 10/11 |
| 处理器 | 1GHz | 2GHz及以上 |
| 内存 | 1GB | 4GB及以上 |
| 硬盘空间 | 350MB | 1GB以上 |
| 显示器 | 1024×768 | 1920×1080 |
1.支持导出为Microsoft Word文档,保留原始排版和格式,方便直接编辑。
2.可输出为Excel表格文件,表格数据和结构能够精准还原。
3.支持生成可搜索PDF文件,既保留原始版面又支持文字检索。
4.可导出为HTML网页格式,方便将文档内容发布到网站。
5.支持纯文本TXT格式输出,适合只需提取文字内容的场景。
6.还能输出为PPT、RTF、CSV等多种格式,满足不同办公需求。
1.办公室文员可以用它快速将纸质文件数字化,提高文档管理效率。
2.科研人员可以借助它提取文献资料中的文字和表格数据。
3.图书管理员可用它进行古籍和珍贵文献的数字化保存。
4.财务人员可以用它识别发票、账单等票据信息,减少手动录入。
5.学生群体可以用它整理扫描版教材和笔记,方便复习和检索。
6.翻译工作者可以用它先将图片文档转为可编辑文本,再进行翻译处理。
此内容由AI根据文章内容自动生成,并已由人工审核



1Checker最新版 2.1.7.0 电脑版10.0M / 英文 / 2.1.7.0 电脑版
下载汉语字霸软件 6.2.0.1 电脑版10.2M / 中文 / 6.2.0.1 电脑版
下载清晰花瓣露珠背景PPT模板 1.0 最新版3.3M / 中文 / 1.0 最新版
下载XML Fox 3.0.0.0 电脑版1.8M / 英文 / 3.0.0.0 电脑版
下载商务元素动态PPT模板 1.0 电脑版2.2M / 中文 / 1.0 电脑版
下载毕业答辩PPT模板 1.0 电脑版1.7M / 中文 / 1.0 电脑版
下载记忆提高大师最新版 1.0.0.0 电脑版10.3M / 中文 / 1.0.0.0 电脑版
下载PPT助手软件 2.2.0.1 电脑版2.3M / 中文 / 2.2.0.1 电脑版
下载SysTools DBX Converter (DBX转换器) 3.2.0.1 电脑版3.8M / 英文 / 3.2.0.1 电脑版
下载小型库存管理系统 2.0 电脑版1.3M / 中文 / 2.0 电脑版
下载读我练口语-影视英语 1.0.0.8 电脑版5.3M / 中文 / 1.0.0.8 电脑版
下载外贸邮件助手pc版 2013.5.21.1 电脑版1.4M / 中文 / 2013.5.21.1 电脑版
下载云竹诗词大典软件 1.00.18 电脑版12.9M / 中文 / 1.00.18 电脑版
下载MathType数学公式编辑器 7.10.1 电脑版43.6M / 英文 / 7.10.1 电脑版
下载给力大辞典 2.80 电脑版79.8M / 中文 / 2.80 电脑版
下载谷歌翻译器pc版 2.2 电脑版9.8M / 中文 / 2.2 电脑版
下载英语语法大全 1.0 电脑版2.0M / 中文 / 1.0 电脑版
下载十四位数仿真科学计算器 2.1.5.0 电脑版614KB / 中文 / 2.1.5.0 电脑版
下载Office 2016 家庭和学生版 16.0.10325.30000 电脑版4.7M / 中文 / 16.0.10325.30000 电脑版
下载糯词笔记软件 2.0.1 电脑版50.7M / 中文 / 2.0.1 电脑版
下载笨笨家庭记账本 V2017 2026 最新版2.4M / 中文 / V2017 2026 最新版
下载BZWB网络办公 2.7 电脑版6.4M / 中文 / 2.7 电脑版
下载福昕PDF转换大师 2.9.1110.408 电脑版17.9M / 中文 / 2.9.1110.408 电脑版
下载闪电PDF阅读器 2.1.5.0 最新版75.1M / 中文 / 2.1.5.0 最新版
下载Doit.im for Windows最新版 1.9.2.3888 电脑版8.4M / 中文 / 1.9.2.3888 电脑版
下载链签-区块链智能合同管理软件最新版 1.0.0.0 电脑版96.7M / 中文 / 1.0.0.0 电脑版
下载CintaNotes 3.0.2.2 电脑版7.7M / 英文 / 3.0.2.2 电脑版
下载易特商店宝 1.0.0.1 电脑版31.1M / 中文 / 1.0.0.1 电脑版
下载Smallpdf转换器 6.8.0.0 电脑版31.3M / 中文 / 6.8.0.0 电脑版
下载W大师PDF转换器 1.3.1.0 电脑版13.7M / 中文 / 1.3.1.0 电脑版
下载myPlan(桌面事务管理) 1.0.0.0 电脑版842KB / 中文 / 1.0.0.0 电脑版
下载GitMind 1.0.8.0 电脑版1.8M / 中文 / 1.0.8.0 电脑版
下载麦库记事软件 6.14.4.17 电脑版18.8M / 中文 / 6.14.4.17 电脑版
下载石墨文档 3.5.0.0 最新版326.4M / 中文 / 3.5.0.0 最新版
下载思想快车(ThinkingExpress ) 2.0.0.1 电脑版934KB / 中文 / 2.0.0.1 电脑版
下载Xmind 2026解锁高级版 26.05.01107最新版本157.3M / 中文 / 26.05.01107最新版本
下载WPS2019博湖县政府版 11.8.2.10229政府定制版279.1M / 中文 / 11.8.2.10229政府定制版
下载WPS Office 2023专业版免会员 12.1.0.26899免费版437.8M / 中文 / 12.1.0.26899免费版
下载WPS Office 2016极限精简版 2020年12月版31.3M / 中文 / 2020年12月版
下载Xmind 2025永久激活版 163.3M / 中文 /
下载福昕PDF阅读器官方正版(Foxit Reader) 2026.2.0.39747 最新版350.9M / 多国语言[中文] / 2026.2.0.39747 最新版
下载InDesign 2024软件 v19.5.0.84直装版1.42G / 中文 / v19.5.0.84直装版
下载LibreOffice最新版本(Office 办公套件) 26.8.0 中文版342.9M / 多国语言[中文] / 26.8.0 中文版
下载PDFgear(PDF工具) 2.1.20 最新版133.8M / 多国语言[中文] / 2.1.20 最新版
下载InDesign 2022破解版 v17.4.0.51中文版958.3M / 中文 / v17.4.0.51中文版
下载veyon(电子教室管理)官方版 4.11.3.0电脑版16.0M / 中文 / 4.11.3.0电脑版
下载Xournal++(手写笔记工具) 1.3.7便携版93.7M / 多国语言[中文] / 1.3.7便携版
下载亿图图示绿色版(EdrawMax) 15.2.9.1577 特别版193.1M / 中文 / 15.2.9.1577 特别版
下载搜狗输入法电脑版最新版本 16.8.0.4914 pc版74.5M / 中文 / 16.8.0.4914 pc版
下载SketchUp版本转换器最新版 1.0.0官方版5.6M / 中文 / 1.0.0官方版
下载给力大辞典绿色便携版 2.20离线版199.6M / 中文 / 2.20离线版
下载Microsoft Office专业增强版2021 RTM 官方正式版4.19G / 英文 / RTM 官方正式版
下载LTspice(电路仿真工具) 26.2 汉化便携版95.0M / 中文 / 26.2 汉化便携版
下载Recoll(文件内容搜索器)绿色中文版 1.28.6单文件版103.8M / 中文 / 1.28.6单文件版
下载给力牛津词典官方PC版 2.0电脑版92.7M / 中文 / 2.0电脑版
下载wps桌面版 12.1,0.26895最新版285.7M / 中文 / 12.1,0.26895最新版
下载AI语音合成官方版 0.70电脑版553KB / 中文 / 0.70电脑版
下载Xmind 2021简体中文永久安装版 193M / 中文 /
下载Obsidian(黑曜石Markdown笔记) 1.13.7 电脑版315.7M / 多国语言[中文] / 1.13.7 电脑版
下载XMind 2023激活版免费版 136.5M / 中文 /
下载我的ABC软件工具箱软件 6.6.1 最新版150.5M / 中文 / 6.6.1 最新版
下载Cherry Studio智能体(模型服务聚合) 2.0.12 PC版283.9M / 中文 / 2.0.12 PC版
下载OfficeMind官方版 1.1.14 最新版27.8M / 中文 / 1.1.14 最新版
下载微软office2024镜像激活版 长期支持版26年07月更新版3.02G / 中文 / 长期支持版26年07月更新版
下载Adobe InDesign 2026中文激活版 21.6.0.57电脑版1.50G / 中文 / 21.6.0.57电脑版
下载WorkBuddy AI办公助手 5.3.8 最新版388.4M / 中文 / 5.3.8 最新版
下载万彩办公大师(OfficeBox)绿色便携版 3.0.7绿色免费版16.9M / 中文 / 3.0.7绿色免费版
下载InDesign 2025免费版本 v20.5.0.48中文版1.48G / 中文 / v20.5.0.48中文版
下载universal extractor(万能解包提取工具) 2022-01-06 中文增强版45.1M / 中文 / 2022-01-06 中文增强版
下载谷歌日语输入法 1.3.21.111最新版723KB / 中文 / 1.3.21.111最新版
下载