
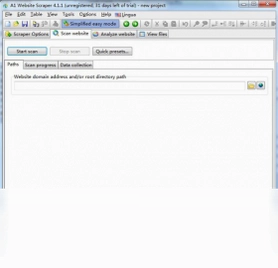
A1 Website Scraper 是一款专业的网站数据采集与提取工具,能够帮助用户快速抓取网页中的各类信息并导出为定制化的 CSV 文件。无论是电商价格监控、竞品数据分析,还是内容聚合整理,这款软件都能通过灵活的规则配置实现高效采集。其直观的操作界面让初学者也能轻松上手,同时强大的过滤与去重功能满足了专业用户的深度需求,是数据工作者不可或缺的实用利器。
1.启动 A1 Website Scraper 并完成目标网站的采集配置后,点击主界面顶部菜单栏的“文件”选项。
2.在下拉菜单中找到“导出数据”功能,点击后会弹出格式选择窗口。
3.软件默认支持 CSV、TXT、HTML 以及 XML 四种常用格式,根据后续处理需求勾选对应选项。
4.若选择 CSV 格式,还可以进一步设置分隔符类型,如逗号、分号或制表符,确保与 Excel 等工具兼容。
5.确认导出路径和文件名后点击“保存”,软件会立即将当前采集结果写入指定文件。
6.对于需要定期导出的用户,可以在“计划任务”中预设自动导出规则,实现无人值守的数据落地。
1.打开软件后新建一个项目,在起始网址栏输入需要采集的网站首页地址。
2.进入“采集规则”面板,通过可视化选择器点选网页中需要提取的数据区域,如标题、价格、链接等。
3.为每个字段命名并设置对应的 CSS 选择器或 XPath 路径,确保定位精准。
4.在“过滤条件”中添加关键词排除或包含规则,避免采集到无关内容。
5.设置翻页规则,指定“下一页”按钮的链接特征,让软件自动遍历多页数据。
6.点击“测试运行”预览采集结果,确认无误后保存规则并启动正式采集任务。
| 快捷键组合 | 功能说明 |
|---|---|
| Ctrl + N | 新建采集项目 |
| Ctrl + O | 打开已有项目文件 |
| Ctrl + S | 保存当前项目配置 |
| F5 | 开始或暂停采集任务 |
| Ctrl + E | 快速导出采集数据 |
| Ctrl + F | 在结果中查找关键词 |
| 配置项 | 最低要求 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7 | Windows 10/11 |
| 处理器 | 1 GHz | 2 GHz 及以上 |
| 内存 | 1 GB | 4 GB 及以上 |
| 硬盘空间 | 50 MB | 200 MB 以上 |
| 网络 | 宽带连接 | 稳定高速网络 |
1.在软件设置中开启“模拟浏览器”模式,让请求头信息更接近真实用户访问。
2.调整采集速度,将并发线程数降低至 1-2 个,并在请求间隔中设置随机延迟时间。
3.启用代理服务器功能,在“网络设置”中导入可用的代理 IP 列表,实现轮换访问。
4.针对需要登录的网站,使用软件内置的 Cookie 管理功能导入已登录状态的会话信息。
5.若目标网站使用 JavaScript 动态加载内容,可开启“渲染 JavaScript”选项等待页面完全加载后再提取数据。
6.定期更新软件版本,开发者会针对常见反爬机制更新绕过策略。
1.在项目编辑界面完成所有采集规则配置后,点击工具栏上的“计划任务”按钮。
2.在弹出的计划任务窗口中点击“添加”,创建一个新的定时任务。
3.设置任务名称并选择触发频率,支持按小时、按天、按周或自定义 Cron 表达式。
4.指定每次执行时需要运行的项目以及导出数据的保存路径和格式。
5.勾选“任务完成后发送邮件通知”,填写接收邮箱以便及时了解采集状态。
6.保存计划后确保软件保持在后台运行状态,到达设定时间即会自动启动采集。
1.进入“数据管理”面板,找到“去重设置”选项卡。
2.选择用于判断重复的字段,例如商品链接或标题,可同时勾选多个字段组合判断。
3.启用“采集时实时去重”功能,软件会在写入数据前自动比对已有记录。
4.对于已采集的历史数据,点击“批量去重”按钮,选择保留第一条或最后一条记录。
5.设置模糊匹配阈值,当标题相似度超过设定百分比时视为重复内容。
6.去重完成后可通过“导出报告”查看被过滤掉的重复条目数量及详情。
此内容由AI根据文章内容自动生成,并已由人工审核



高速浏览器 1.0.0.1 电脑版46.7M / 中文 / 1.0.0.1 电脑版
下载XT800个人版最新版 5.1.2.4727 电脑版5.6M / 中文 / 5.1.2.4727 电脑版
下载环宇浏览器软件 1.0.0.0 电脑版46.7M / 中文 / 1.0.0.0 电脑版
下载All网站图片批量软件 3.17.6.0 电脑版4.1M / 中文 / 3.17.6.0 电脑版
下载小云蜂巢软件 0.0.4.0 电脑版32.1M / 中文 / 0.0.4.0 电脑版
下载Xftp最新版 5.0.1228 电脑版30.6M / 中文 / 5.0.1228 电脑版
下载小懂上网软件 2.00.0526 电脑版11.3M / 中文 / 2.00.0526 电脑版
下载HTTP Spy .NET HTTP网络请求分析工具 4.1.0.0 电脑版576KB / 英文 / 4.1.0.0 电脑版
下载WinWAP for Windows 4.2.0.290 电脑版2.8M / 英文 / 4.2.0.290 电脑版
下载赛猫购购返利浏览器软件 1.9.3841.8217 电脑版3.4M / 中文 / 1.9.3841.8217 电脑版
下载闪电极速浏览器软件 1.0.5.1 电脑版88.6M / 中文 / 1.0.5.1 电脑版
下载闪电安全浏览器软件 1.0.5.3 电脑版88.8M / 中文 / 1.0.5.3 电脑版
下载紫狐浏览器 1.9.2.3958 电脑版15.7M / 中文 / 1.9.2.3958 电脑版
下载随知插件 1.3.3 pc版22.4M / 中文 / 1.3.3 pc版
下载柚子浏览器软件 1.2.0.0 电脑版4.9M / 中文 / 1.2.0.0 电脑版
下载飞火浏览器pc版 2.3.7.1230 电脑版45.9M / 中文 / 2.3.7.1230 电脑版
下载好卓搜搜 3.3.106.210 电脑版6.7M / 中文 / 3.3.106.210 电脑版
下载Deluge 1.3.15 电脑版15.4M / 多国语言[中文] / 1.3.15 电脑版
下载迷你电驴 1.0.0.1 电脑版3.1M / 中文 / 1.0.0.1 电脑版
下载网络硬盘下载工具 2008.3.11.0 电脑版1.4M / 中文 / 2008.3.11.0 电脑版
下载快车(FlashGet) 3.7.0.1223 电脑版7.6M / 中文 / 3.7.0.1223 电脑版
下载纳米机器人 2.2.7.6 最新版666KB / 中文 / 2.2.7.6 最新版
下载网络传送带 (Net Transport) 2.96.10.700 最新版4.3M / 中文 / 2.96.10.700 最新版
下载eMule 0.50.0.4 电脑版3.2M / 多国语言[中文] / 0.50.0.4 电脑版
下载Fresh Download (Fresh下载) 8.79.0.0 电脑版2.1M / 英文 / 8.79.0.0 电脑版
下载111安全浏览器软件 1.0.0.4 电脑版38.2M / 中文 / 1.0.0.4 电脑版
下载商刷 1.0.0 电脑版20.8M / 中文 / 1.0.0 电脑版
下载WinGate 9.4.0.5993 电脑版67.7M / 英文 / 9.4.0.5993 电脑版
下载Google Drive 桌面版 2.34.5075.1619 电脑版1.1M / / 2.34.5075.1619 电脑版
下载Floorp浏览器电脑版 12.18.1最新版109.2M / 多国语言[中文] / 12.18.1最新版
下载LeapFTP软件 3.1.0.50 电脑版2.5M / 英文 / 3.1.0.50 电脑版
下载Hydra Download Manager(全平台图形下载器) 0.6.1 绿色版13.1M / 多国语言[中文] / 0.6.1 绿色版
下载RaySource软件 2.5.0.1 电脑版6.1M / 中文 / 2.5.0.1 电脑版
下载FTPRush 2.1.8 电脑版3.8M / 英文 / 2.1.8 电脑版
下载FreeRapid Downloader 0.8.0.0 电脑版13.6M / 英文 / 0.8.0.0 电脑版
下载NetLimiter Pro(网络防火墙) 5.3.27.0 电脑版18.3M / 多国语言[中文] / 5.3.27.0 电脑版
下载火狐浏览器官方最新版本 106.0.2离线安装包54.7M / 中文 / 106.0.2离线安装包
下载唧唧down最新版(哔哩哔哩视频音频下载器) 1.229.1便携版8.1M / 中文 / 1.229.1便携版
下载谷歌浏览器最新版本电脑版(Google Chrome) 153.0.8010.58版本159.9M / 中文 / 153.0.8010.58版本
下载Xshell绿色版免安装 8.0.0110 特别版20.5M / 多国语言[中文] / 8.0.0110 特别版
下载迅雷绿色版免费 12.4.12.4000电脑版95.8M / 中文 / 12.4.12.4000电脑版
下载Internet Download Manager免激活版 6.43.11 最新版6.7M / 多国语言[中文] / 6.43.11 最新版
下载Chrome win7离线安装包 109.0.5414.168 便携版85.0M / 多国语言[中文] / 109.0.5414.168 便携版
下载迅雷pc版安装包 12.4.10.3940版本7.9M / 中文 / 12.4.10.3940版本
下载Wireshark官方正版 4.6.8便携版139.9M / 中文 / 4.6.8便携版
下载哔哩下载姬最新版(B站视频下载工具) 1.5.4电脑版30.2M / 中文 / 1.5.4电脑版
下载ode多功能助手电脑版 1.4.3pc版76.9M / 中文 / 1.4.3pc版
下载AB Download Manager最新版本(下载工具) 1.10.4 绿色版88.4M / 中文 / 1.10.4 绿色版
下载迅雷17绿色精简版 25.1.12.1636绿色版135M / 中文 / 25.1.12.1636绿色版
下载阿里云盘便携版 2.2.1.761免安装版59.5M / 中文 / 2.2.1.761免安装版
下载Ghost Downloader最新版(多线程下载器) 4.3.7 电脑版43.7M / 英文 / 4.3.7 电脑版
下载Neat Download Manager最新版 1.2.24汉化版733KB / 中文 / 1.2.24汉化版
下载火狐浏览器tete009版 153.0.4 绿色便携版89.2M / 中文 / 153.0.4 绿色便携版
下载FluxDown最新版本 0.4.7 便携版28.5M / 多国语言[中文] / 0.4.7 便携版
下载qBittorrent便携版 5.2.3.10 绿色版26.4M / 多国语言[中文] / 5.2.3.10 绿色版
下载CloudDrive2 Windows版 1.0.16 官方版158.8M / 中文 / 1.0.16 官方版
下载Chromium浏览器电脑版 154.0.8029.0 最新版339.3M / 中文 / 154.0.8029.0 最新版
下载群晖 DS918 6.23 引导文件(img和vmdk) 50M / 中文 /
下载Ungoogled Chromium电脑版 153.0.8010.52-1.1最新版本188.9M / 中文 / 153.0.8010.52-1.1最新版本
下载闪豆下载器电脑版 2026年06月25更新版84.3M / 中文 / 2026年06月25更新版
下载Hydra Download Manager(全平台图形下载器) 0.6.1 绿色版13.1M / 多国语言[中文] / 0.6.1 绿色版
下载小白羊网盘官方电脑版(BoxPlayer) 5.0.30 pc版128.6M / 中文 / 5.0.30 pc版
下载NetTool(IP配置工具)最新版 2.0绿色单文件版34KB / 中文 / 2.0绿色单文件版
下载欧朋浏览器国际版 77.0.4054.80绿色版80M / 中文 / 77.0.4054.80绿色版
下载MotrixNext(下载工具) 3.9.7 最新版15.2M / 多国语言[中文] / 3.9.7 最新版
下载向日葵远程控制 16.5.0.30905 最新版163.8M / 中文 / 16.5.0.30905 最新版
下载水狐浏览器官方正版(Waterfox) 6.7.4最新版99.1M / 多国语言[中文] / 6.7.4最新版
下载光鸭云盘桌面版 1.0.0 官方版160.8M / 中文 / 1.0.0 官方版
下载阿里云盘pc版本 6.9.1最新版139.1M / 中文 / 6.9.1最新版
下载阿里云盘小白羊版本 1.6.29免费版47.8M / 中文 / 1.6.29免费版
下载