
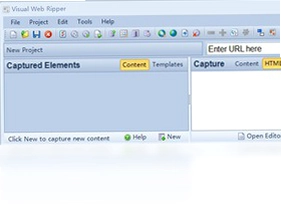
Visual Web Ripper是一款功能强大且操作简单的网页数据提取软件,能够帮助用户快速抓取网页中的各类数据信息。该软件支持自动爬取整个网站页面,将搜集到的所有内容、结果智能储存至数据库或XML文档中。用户只需输入目标网站地址,软件便会自动识别网页结构并划分成一个个数据区间,点击任意区间即可显示对应代码,让您轻松完整地采集整个网站数据,是数据采集与信息整理的得力助手。
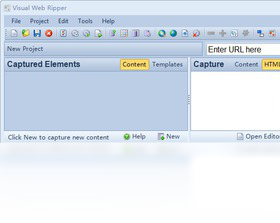
1.首先从官方渠道获取Visual Web Ripper安装包,双击运行安装程序,按照提示完成软件安装并启动。
2.进入主界面后,在地址栏输入您想要抓取数据的目标网站URL地址,确认无误后点击加载按钮。
3.等待软件自动分析网页结构,页面会按照数据区间被划分成多个可点击区域,方便您定位目标数据。
4.点击您需要采集的数据区间,程序框上方会显示该区间对应的HTML代码,确认无误后添加到采集规则中。
5.根据需要设置翻页规则和采集深度,让软件自动遍历整个网站的所有相关页面。
6.配置数据输出格式,可选择数据库或XML文档,设置完成后点击开始采集即可自动运行。
1.Visual Web Ripper支持将采集到的数据导出为XML文档格式,方便后续进行数据交换和二次处理。
2.软件支持直接连接数据库进行数据存储,可将抓取结果写入数据库表中长期保存。
3.用户还可以将数据导出为CSV格式,便于使用Excel等表格软件打开和分析。
4.对于需要进一步加工的数据,可以导出为文本文件,灵活适配各种数据处理流程。
5.软件内置数据预览功能,导出前可先查看采集结果,确认数据准确性后再执行导出操作。
| 快捷键 | 功能说明 |
|---|---|
| Ctrl + N | 新建采集项目 |
| Ctrl + O | 打开已有项目文件 |
| Ctrl + S | 保存当前项目 |
| F5 | 开始执行采集任务 |
| F6 | 暂停当前采集任务 |
| Ctrl + E | 导出采集数据 |
| 配置项 | 最低要求 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7 | Windows 10/11 |
| 处理器 | 1GHz 及以上 | 双核 2GHz 及以上 |
| 内存 | 1GB | 4GB 及以上 |
| 硬盘空间 | 100MB 可用空间 | 500MB 以上 |
| 网络 | 可联网 | 稳定宽带连接 |
1.打开Visual Web Ripper后先建立新项目,输入目标网站首页地址让软件自动加载页面结构。
2.在页面预览区点击需要采集的数据区域,软件会自动生成对应的采集字段和规则。
3.为每个采集字段设置合适的名称和数据类型,便于后续数据整理和导出时识别。
4.设置翻页链接的定位规则,确保软件能自动跳转到下一页继续采集数据。
5.配置采集延迟时间,避免请求过于频繁导致目标网站限制访问。
6.保存规则模板,下次采集同类网站时可直接调用,大幅提升工作效率。
1.如果软件无法加载目标网页,请检查网络连接是否正常,并确认网址输入无误。
2.当采集数据出现乱码时,可在设置中调整字符编码格式,通常选择UTF-8即可解决。
3.若采集速度过慢,可以适当增加并发线程数,但需注意不要给目标网站造成过大压力。
4.遇到软件卡顿或无响应,建议关闭其他占用资源的程序,或升级电脑内存配置。
5.采集结果不完整时,检查翻页规则是否正确设置,确保所有目标页面都被覆盖到。
6.如果导出数据失败,确认输出路径是否有写入权限,并检查磁盘空间是否充足。
1.数据分析人员可以使用Visual Web Ripper快速采集行业数据,为市场分析提供原始素材。
2.电商运营者能够抓取竞品价格和商品信息,辅助制定更有竞争力的销售策略。
3.学术研究人员可利用该软件收集网络公开数据,为科研项目提供数据支撑。
4.网站管理员可以采集站内页面信息,用于网站内容审计和SEO优化分析。
5.市场营销人员能够批量获取潜在客户信息,提升精准营销的效率和效果。
6.对于需要定期监控特定网站更新的用户,Visual Web Ripper的自动化采集功能尤为实用。
此内容由AI根据文章内容自动生成,并已由人工审核



WebZip压缩工具 7.0.0.1025 电脑版1.4M / 英文 / 7.0.0.1025 电脑版
下载Website Extractor软件 10.2 电脑版1.1M / 英文 / 10.2 电脑版
下载小白羊网盘官方电脑版(BoxPlayer) 5.0.35 pc版183.1M / 中文 / 5.0.35 pc版
下载DevSidecar 2.3.1 最新版126.7M / 中文 / 2.3.1 最新版
下载Web Log Suite最新版 9.0 电脑版10.3M / 英文 / 9.0 电脑版
下载WakeMeOnLan(局域网唤醒工具) 1.4.0.0 电脑版190KB / 英文 / 1.4.0.0 电脑版
下载Woterm(远程管理工具) 10.7.6 便携版40.8M / 多国语言[中文] / 10.7.6 便携版
下载WebSiteSniffer(网站嗅探器) 1.2.6.0 电脑版190KB / 英文 / 1.2.6.0 电脑版
下载WebCookiesSniffer 1.1.2.0 最新版58KB / 英文 / 1.1.2.0 最新版
下载Weare Ftp Client 1.0.1.0 电脑版2.1M / 英文 / 1.0.1.0 电脑版
下载WinHTTrack HTTrack 3.46.1 电脑版3.7M / 英文 / 3.46.1 电脑版
下载WISE-FTP 7.0.6 最新版6.6M / 英文 / 7.0.6 最新版
下载云推微博营销评论软件 1.1 电脑版1.9M / 中文 / 1.1 电脑版
下载云里关键词挖掘大师软件 1.7.0.0 电脑版678KB / 中文 / 1.7.0.0 电脑版
下载MapRoamer(全球地图漫游) 1.0.0.1 电脑版471KB / 英文 / 1.0.0.1 电脑版
下载共享卫士 2.11.15.0 电脑版6.8M / 中文 / 2.11.15.0 电脑版
下载Ungoogled Chromium电脑版 154.0.8037.97-1.1最新版本189.1M / 中文 / 154.0.8037.97-1.1最新版本
下载Ketch(Kotlin Multiplatform 下载管理器) 0.3.1 电脑版61.0M / 中文 / 0.3.1 电脑版
下载RouterPassView软件 1.4.5.0 电脑版65KB / 英文 / 1.4.5.0 电脑版
下载Encrypted FTP (加密FTP) 3.3.1.145 电脑版2.9M / 英文 / 3.3.1.145 电脑版
下载Wing FTP Server服务器 8.2.6企业版78.9M / 中文 / 8.2.6企业版
下载Internet Download Manager免激活版 6.43.15 最新版6.5M / 多国语言[中文] / 6.43.15 最新版
下载Easy Net Switch 3.20 电脑版1.2M / 英文 / 3.20 电脑版
下载dsl webhosting(动态IP解析建站系统) 2.1 电脑版1007KB / 中文 / 2.1 电脑版
下载DEKSI Network Inventory(网络资产管理系统) 10.4 电脑版8.4M / 英文 / 10.4 电脑版
下载谷歌浏览器最新版本电脑版(Google Chrome) 155.0.8059.40版本161.8M / 中文 / 155.0.8059.40版本
下载currports (CurrPorts端口查看器) 1.8.3.0 电脑版46KB / 英文 / 1.8.3.0 电脑版
下载GoodSync官方正版 12.11.9.9免费版53.8M / 多国语言[中文] / 12.11.9.9免费版
下载qBittorrent便携版 5.2.4.10 绿色版22.2M / 多国语言[中文] / 5.2.4.10 绿色版
下载Web Page Maker 3.1.2.199 电脑版1.1M / 英文 / 3.1.2.199 电脑版
下载WinSSHD 6.44.0.0 电脑版10.8M / 英文 / 6.44.0.0 电脑版
下载Web Dumper(网站下载器) 3.3.3 电脑版2.9M / 英文 / 3.3.3 电脑版
下载SphereXP (SphereXPlorer) 1.4.10.0 电脑版6.7M / 英文 / 1.4.10.0 电脑版
下载AnyPicDownloader (图片批量下载器) 16.0.0.0 电脑版2.1M / 中文 / 16.0.0.0 电脑版
下载Ability FTP Server软件 2010.4.0.0 电脑版3.7M / 英文 / 2010.4.0.0 电脑版
下载NetLimiter Pro(网络防火墙) 5.3.27.0 电脑版18.3M / 多国语言[中文] / 5.3.27.0 电脑版
下载火狐浏览器官方最新版本 106.0.2离线安装包54.7M / 中文 / 106.0.2离线安装包
下载Xshell绿色版免安装 8.0.0110 特别版20.5M / 多国语言[中文] / 8.0.0110 特别版
下载唧唧down最新版(哔哩哔哩视频音频下载器) 1.229.1便携版8.1M / 中文 / 1.229.1便携版
下载谷歌浏览器最新版本电脑版(Google Chrome) 155.0.8059.40版本161.8M / 中文 / 155.0.8059.40版本
下载迅雷绿色版免费 12.4.12.4000电脑版95.8M / 中文 / 12.4.12.4000电脑版
下载Chrome win7离线安装包 109.0.5414.168 便携版85.0M / 多国语言[中文] / 109.0.5414.168 便携版
下载Internet Download Manager免激活版 6.43.15 最新版6.5M / 多国语言[中文] / 6.43.15 最新版
下载迅雷pc版安装包 12.4.10.3940版本7.9M / 中文 / 12.4.10.3940版本
下载Wireshark官方正版 4.6.8便携版139.9M / 中文 / 4.6.8便携版
下载迅雷17绿色精简版 25.1.12.1636绿色版135M / 中文 / 25.1.12.1636绿色版
下载哔哩下载姬最新版(B站视频下载工具) 1.5.4电脑版30.2M / 中文 / 1.5.4电脑版
下载ode多功能助手电脑版 1.4.3pc版76.9M / 中文 / 1.4.3pc版
下载AB Download Manager最新版本(下载工具) 1.10.4 绿色版88.4M / 中文 / 1.10.4 绿色版
下载阿里云盘便携版 2.2.1.761免安装版59.5M / 中文 / 2.2.1.761免安装版
下载Ghost Downloader最新版(多线程下载器) 4.3.7 电脑版43.7M / 英文 / 4.3.7 电脑版
下载Neat Download Manager最新版 1.2.24汉化版733KB / 中文 / 1.2.24汉化版
下载火狐浏览器tete009版 153.0.4 绿色便携版89.2M / 中文 / 153.0.4 绿色便携版
下载FluxDown最新版本 0.4.7 便携版28.5M / 多国语言[中文] / 0.4.7 便携版
下载CloudDrive2 Windows版 1.0.16 官方版158.8M / 中文 / 1.0.16 官方版
下载qBittorrent便携版 5.2.4.10 绿色版22.2M / 多国语言[中文] / 5.2.4.10 绿色版
下载Chromium浏览器电脑版 154.0.8029.0 最新版339.3M / 中文 / 154.0.8029.0 最新版
下载Ungoogled Chromium电脑版 154.0.8037.97-1.1最新版本189.1M / 中文 / 154.0.8037.97-1.1最新版本
下载群晖 DS918 6.23 引导文件(img和vmdk) 50M / 中文 /
下载Hydra Download Manager(全平台图形下载器) 1.0.1 绿色版13.4M / 多国语言[中文] / 1.0.1 绿色版
下载闪豆下载器电脑版 2026年06月25更新版84.3M / 中文 / 2026年06月25更新版
下载小白羊网盘官方电脑版(BoxPlayer) 5.0.35 pc版183.1M / 中文 / 5.0.35 pc版
下载向日葵远程控制 16.5.0.30905 最新版163.8M / 中文 / 16.5.0.30905 最新版
下载NetTool(IP配置工具)最新版 2.0绿色单文件版34KB / 中文 / 2.0绿色单文件版
下载光鸭云盘桌面版 1.0.0 官方版160.8M / 中文 / 1.0.0 官方版
下载FileZilla Pro(开源FTP工具) 3.71.1 绿色版16.2M / 多国语言[中文] / 3.71.1 绿色版
下载水狐浏览器官方正版(Waterfox) 6.7.4最新版99.1M / 多国语言[中文] / 6.7.4最新版
下载MotrixNext(下载工具) 3.9.7 最新版15.2M / 多国语言[中文] / 3.9.7 最新版
下载欧朋浏览器国际版 77.0.4054.80绿色版80M / 中文 / 77.0.4054.80绿色版
下载阿里云盘pc版本 6.9.1最新版139.1M / 中文 / 6.9.1最新版
下载